Определите, что значит правильный ответ
Генерация с дополнением поиском (RAG) передаёт модели релевантные исходные материалы до того, как она ответит. Это помогает при работе с меняющимися или закрытыми знаниями, но поиск не гарантирует, что найденный материал верен, полон или доступен данному пользователю.
Начните с узкого сценария, например с ответов на вопросы по версионированному руководству к продукту. Запишите примеры приемлемых ответов, нужные им ссылки на источники и случаи, когда система должна отказаться отвечать или передать вопрос человеку. Отделите генерацию ответов от инструментов, которые изменяют бизнес-данные.
Подготовьте документы к поиску
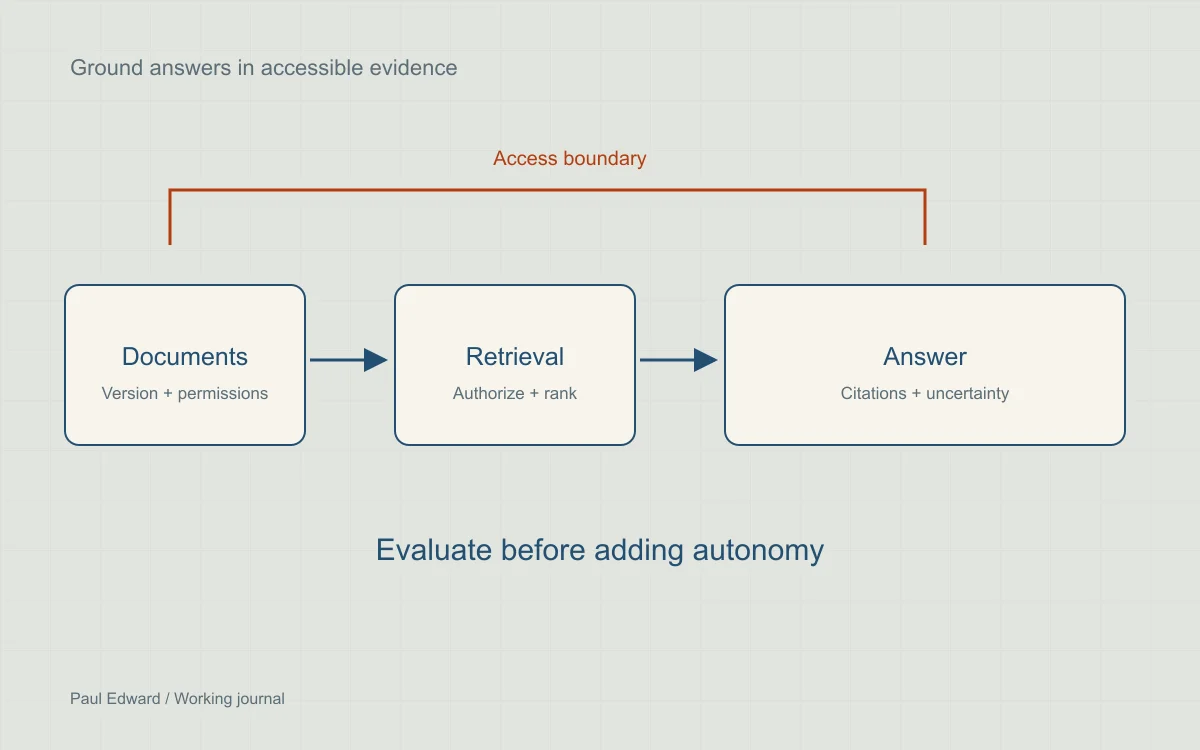
Сохраняйте заголовки, контекст таблиц, номера версий и URL источников. Присвойте каждому фрагменту стабильный идентификатор документа и сохраните его правила доступа и дату редакции. Делите текст по осмысленным смысловым границам, а не исходя из того, что одно количество токенов подойдёт любому документу. Проверяйте вопросы, ответы на которые охватывают два раздела или зависят от сноски.
Удаление документов и изменение прав доступа должны доходить до поисковых индексов и кешей. Повторное построение эмбеддингов документа не должно оставлять старых доступных фрагментов. Фиксируйте сбои загрузки, чтобы операторы видели, каких данных не хватает.
Сравните подходы к поиску
Точные термины — коды ошибок, артикулы и номера версий — часто лучше находит поиск по ключевым словам. Эмбеддинги помогают с концептуальным сходством. Гибридная система может объединять оба набора результатов и использовать слияние рейтингов или переранжирование, но это добавляет затраты и задержку.
Прежде чем добавлять этапы, соберите размеченный набор вопросов. Измерьте, попадают ли релевантные и разрешённые фрагменты в найденный набор, а затем — опирается ли итоговый ответ на эти фрагменты. Включите неоднозначные, не имеющие ответа и устаревшие вопросы. Точность на выбранном пороге — это метрика поиска, а не мера общей фактической точности.
Применяйте права доступа до того, как раскрывать контекст
- Аутентифицируйте пользователя и определяйте права клиента и доступ к документам в доверенном коде приложения.
- Применяйте ограничения авторизации к поиску и проверяйте отобранные фрагменты, прежде чем они попадут в модель.
- Считайте найденный текст недоверенными данными. Инструкция в документе раскрыть секреты или вызвать инструмент не должна отменять политику приложения.
- Ограничьте инструменты необходимыми операциями; проверяйте аргументы, права и бизнес-правила независимо от вывода модели.
- Требуйте подходящего подтверждения или проверки для значимых действий и ведите минимальный журнал аудита.
Контролируйте затраты, не выдавая неверных ответов
Учитывайте отдельно затраты на поиск, эмбеддинги, переранжирование и генерацию, а также задержку p50 и p95. Ограничьте контекст фрагментами, которые помогают ответить на вопрос, задайте предел длины вывода и выбирайте мощность модели по своему набору для оценки.
Начинайте кеширование с точных совпадений и ясной стратегии инвалидации. Ограничивайте ключи клиентом, версией политики доступа, версией документа, моделью и версией промпта. Похожей формулировки недостаточно, чтобы считать, что два пользователя имеют право на один и тот же ответ. Семантическому кешу нужны дополнительные проверки на ложные совпадения и устаревшие ответы; к тому же он всё равно требует работы поиска или эмбеддингов.
Выпускайте с измеримым критерием приёмки
Задайте пороги, соответствующие риску сценария. Проверяйте ссылки на источники, отказы, границы прав, вредоносные документы, тайм-ауты и сбои инструментов. Структурированный JSON делает разбор надёжным, но валидная схема не делает утверждение истинным, а действие — разрешённым.
После релиза разбирайте ошибочные ответы и промахи поиска. Добавляйте их в отложенный регрессионный набор, а не подстраивайте систему только под демонстрацию. Показывайте пользователю подтверждающий источник и делайте неопределённость видимой, когда доступные материалы не позволяют ответить на вопрос.
Частые вопросы
Мешает ли RAG системе ИИ выдумывать ответы?
Нет. Поиск может дать полезные данные, но фрагменты бывают неполными, устаревшими или нерелевантными, а модель может неверно их истолковать. Проверяйте, опирается ли итоговый ответ на отобранные источники, и определите, когда система должна отказаться отвечать или передать вопрос человеку.
Как не допустить, чтобы один клиент увидел документы другого?
Применяйте права клиента и доступ к документам в доверенном коде приложения до того, как данные попадут в модель. Повторно проверяйте отобранные фрагменты и ограничивайте кеши соответствующей политикой доступа и версиями контента. Промпт, который просит модель соблюдать права доступа, не является барьером авторизации.
Использовать поиск по ключевым словам, векторный поиск или оба?
Сначала проверьте типичные вопросы. Точные идентификаторы и коды ошибок часто требуют совпадения по ключевым словам, а эмбеддинги помогают с концептуальным сходством. Сравните качество поиска, обоснованность ответов, задержку и стоимость, прежде чем добавлять гибридный поиск или переранжирование.
Когда кешировать ответ ИИ безопасно?
Только если ключ кеша и правила инвалидации сохраняют требования к правам доступа и актуальности ответа. Включайте версии клиента, политики, документа, модели и промпта, когда это важно. Похожая формулировка сама по себе не доказывает, что два пользователя могут получить один и тот же ответ.
Источники и дополнительное чтение
Читайте дальше
Узнайте о разработке ИИ-приложений или прочитайте руководство по очередям и идемпотентности для надёжных фоновых процессов.
Leave a Reply