Defina o que é uma resposta correta
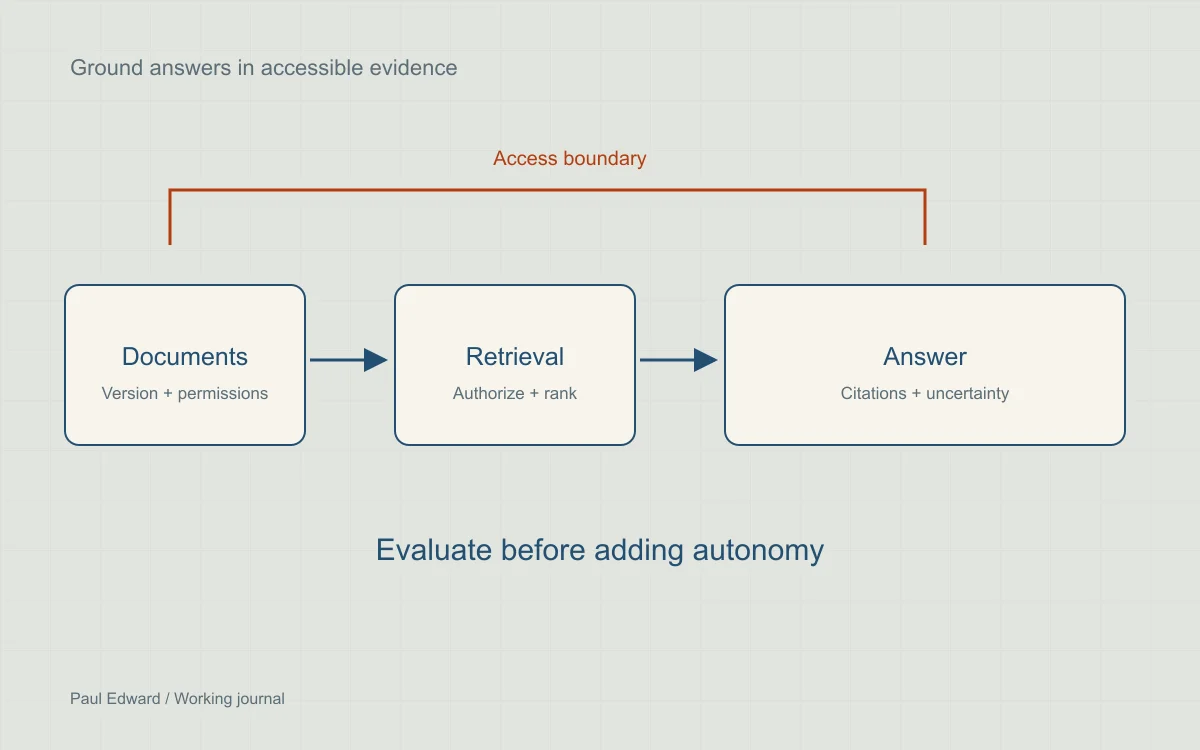
A geração aumentada por recuperação (RAG) fornece ao modelo material de origem relevante antes que ele responda. Ela pode ajudar com conhecimento privado ou que muda com frequência, mas a recuperação não garante que o material recuperado esteja correto, completo ou autorizado para o usuário.
Comece com um caso de uso restrito, como responder perguntas sobre um manual de produto versionado. Escreva exemplos de respostas aceitáveis, as citações que elas precisam e quando o sistema deve se recusar a responder ou escalar. Mantenha a geração de respostas separada das ferramentas que alteram registros do negócio.
Prepare os documentos para a recuperação
Preserve títulos, o contexto das tabelas, números de versão e URLs de origem. Dê a cada trecho um identificador de documento estável e mantenha suas regras de acesso e a data de revisão. Divida em limites semânticos úteis em vez de supor que uma única contagem de tokens serve para todos os documentos. Teste perguntas cujas respostas abrangem duas seções ou dependem de uma nota de rodapé.
Exclusões de documentos e mudanças de permissão precisam se propagar para os índices de busca e os caches. Gerar novamente os embeddings de um documento não pode deixar para trás trechos antigos e acessíveis. Registre as falhas de ingestão para que os operadores vejam quais evidências estão faltando.
Compare abordagens de recuperação
Termos exatos, como códigos de erro, SKUs e números de versão, costumam se beneficiar da busca por palavras-chave. Os embeddings podem ajudar com a similaridade conceitual. Um sistema híbrido pode combinar os dois conjuntos de resultados e usar fusão de rankings ou reordenação, mas isso adiciona custo e latência.
Monte um conjunto de perguntas rotuladas antes de adicionar etapas. Meça se os trechos relevantes e autorizados aparecem no conjunto recuperado e, depois, se a resposta final se apoia nesses trechos. Inclua perguntas ambíguas, sem resposta e desatualizadas. A precisão em um corte escolhido é uma métrica de recuperação, não uma medida da exatidão factual geral.
Aplique o controle de acesso antes de expor o contexto
- Autentique o usuário e estabeleça as permissões de cliente e de documento em código de aplicação confiável.
- Aplique restrições de autorização à recuperação e valide os trechos finais selecionados antes que cheguem ao modelo.
- Trate o texto recuperado como dado não confiável. Uma instrução em um documento para revelar segredos ou chamar uma ferramenta não pode se sobrepor à política da aplicação.
- Restrinja as ferramentas às operações necessárias; valide argumentos, permissões e regras de negócio independentemente da saída do modelo.
- Exija uma etapa adequada de confirmação ou revisão para ações com consequências e mantenha uma trilha de auditoria mínima.
Controle os custos sem compartilhar a resposta errada
Acompanhe separadamente os custos de recuperação, embeddings, reordenação e geração, junto com a latência p50 e p95. Limite o contexto aos trechos que ajudam a responder a pergunta, defina um teto para o tamanho da saída e escolha a capacidade do modelo com base no seu conjunto de avaliação.
Comece o cache com correspondências exatas e uma estratégia clara de invalidação. Delimite as chaves por cliente, versão da política de acesso, versão do documento, modelo e versão do prompt. Uma redação parecida não basta para estabelecer que dois usuários têm direito à mesma resposta. Um cache semântico precisa de testes adicionais contra correspondências falsas e respostas desatualizadas; ele ainda envolve trabalho de recuperação ou de embeddings.
Lance com um critério de aceitação mensurável
Defina limites adequados ao risco do caso de uso. Teste citações, recusas, limites de permissão, documentos maliciosos, timeouts e falhas de ferramentas. Um JSON estruturado pode tornar o parsing confiável, mas um esquema válido não torna uma afirmação verdadeira nem uma ação autorizada.
Revise as respostas com falha e as falhas de recuperação depois do lançamento. Adicione-as a um conjunto de regressão reservado em vez de ajustar o sistema apenas para uma demonstração. Mostre ao usuário a fonte que sustenta a resposta e deixe a incerteza visível quando o material disponível não conseguir resolver a pergunta.
Perguntas frequentes
O RAG impede que um sistema de IA invente respostas?
Não. A recuperação pode fornecer evidências úteis, mas os trechos podem estar incompletos, desatualizados ou ser irrelevantes, e o modelo pode interpretá-los mal. Avalie se a resposta final se apoia nas fontes selecionadas e defina quando o sistema deve se recusar a responder ou escalar.
Como evito que um cliente veja os documentos de outro cliente?
Aplique as permissões de cliente e de documento em código de aplicação confiável antes que as evidências cheguem ao modelo. Verifique novamente os trechos selecionados e delimite os caches pela política de acesso e pelas versões de conteúdo relevantes. Um prompt pedindo ao modelo que respeite as permissões não é uma barreira de autorização.
Devo usar busca por palavras-chave, busca vetorial ou as duas?
Teste primeiro com perguntas representativas. Identificadores exatos e códigos de erro costumam precisar de correspondência por palavra-chave, enquanto os embeddings podem ajudar com a similaridade conceitual. Compare a qualidade da recuperação, o embasamento das respostas, a latência e o custo antes de adicionar recuperação híbrida ou reordenação.
Quando é seguro colocar em cache uma resposta de IA?
Somente quando a chave de cache e as regras de invalidação preservam os requisitos de permissão e de atualidade da resposta. Inclua as versões do cliente, da política, do documento, do modelo e do prompt quando for relevante. Uma redação parecida, por si só, não prova que dois usuários podem receber a mesma resposta.
Fontes e leituras recomendadas
Continue explorando
Conheça o desenvolvimento de aplicações de IA ou o guia de filas e idempotência para fluxos em segundo plano confiáveis.
Leave a Reply