Legen Sie fest, was eine richtige Antwort ist
Retrieval-Augmented Generation (RAG) liefert einem Modell relevantes Quellmaterial, bevor es antwortet. Das kann bei sich änderndem oder internem Wissen helfen, doch Retrieval garantiert nicht, dass das abgerufene Material korrekt, vollständig oder für den Nutzer freigegeben ist.
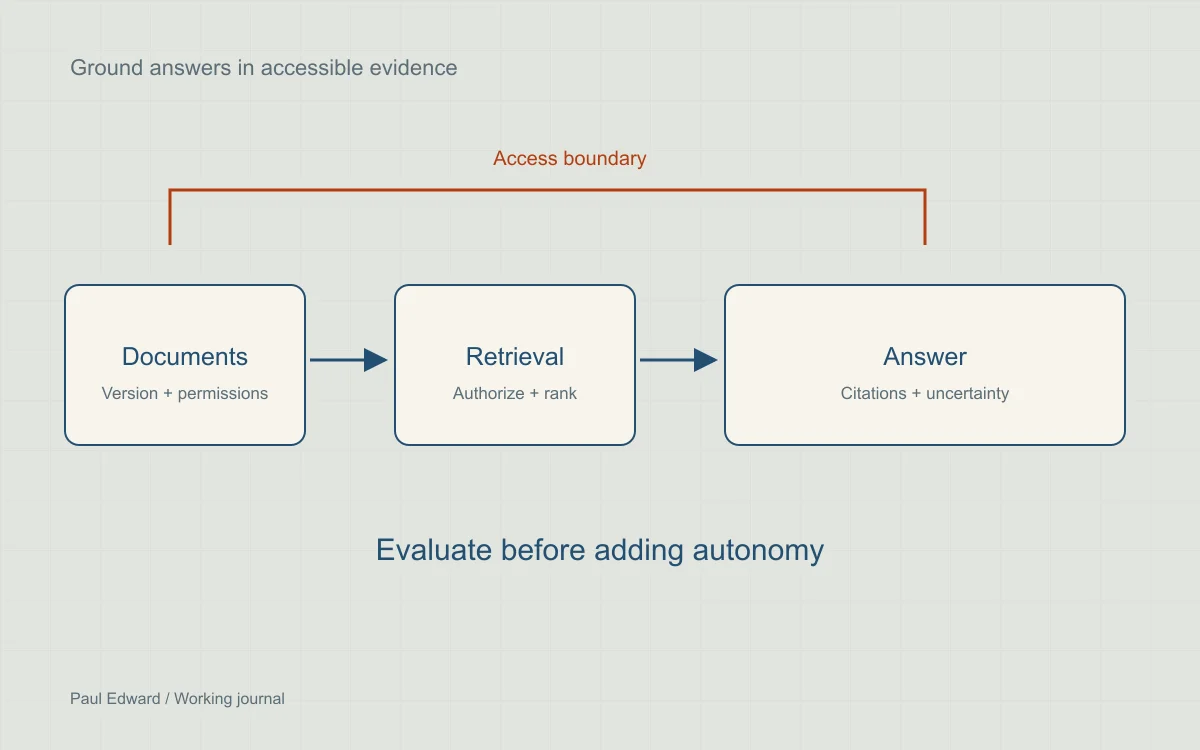
Beginnen Sie mit einem eng gefassten Anwendungsfall, etwa Fragen zu einem versionierten Produkthandbuch. Formulieren Sie Beispiele für akzeptable Antworten, die nötigen Quellenangaben und die Fälle, in denen das System die Antwort verweigern oder eskalieren soll. Trennen Sie die Antwortgenerierung von Werkzeugen, die Geschäftsdaten ändern.
Bereiten Sie Dokumente für das Retrieval vor
Bewahren Sie Überschriften, Tabellenkontext, Versionsnummern und Quell-URLs. Geben Sie jedem Chunk eine stabile Dokument-ID und behalten Sie seine Zugriffsregeln und sein Revisionsdatum bei. Teilen Sie an sinnvollen semantischen Grenzen, statt anzunehmen, dass eine Tokenanzahl für jedes Dokument passt. Testen Sie Fragen, deren Antworten zwei Abschnitte umfassen oder von einer Fußnote abhängen.
Löschungen von Dokumenten und Berechtigungsänderungen müssen sich auf Suchindizes und Caches auswirken. Das erneute Erzeugen von Embeddings darf keine alten, zugänglichen Chunks zurücklassen. Protokollieren Sie Ingest-Fehler, damit das Betriebsteam sieht, welche Belege fehlen.
Vergleichen Sie Retrieval-Ansätze
Exakte Begriffe wie Fehlercodes, Artikelnummern und Versionsnummern profitieren oft von einer Stichwortsuche. Embeddings können bei konzeptueller Ähnlichkeit helfen. Ein hybrides System kann beide Ergebnismengen kombinieren und Rank Fusion oder Reranking einsetzen, erhöht aber Kosten und Latenz.
Erstellen Sie ein gelabeltes Fragenset, bevor Sie weitere Stufen hinzufügen. Messen Sie, ob relevante und freigegebene Passagen in der abgerufenen Menge auftauchen und ob die endgültige Antwort durch diese Passagen gestützt wird. Nehmen Sie mehrdeutige, unbeantwortbare und veraltete Fragen auf. Die Präzision bei einem gewählten Cutoff ist eine Retrieval-Metrik, kein Maß für die sachliche Richtigkeit insgesamt.
Setzen Sie Zugriffsregeln durch, bevor Sie Kontext preisgeben
- Authentifizieren Sie den Nutzer und ermitteln Sie Mandanten- und Dokumentberechtigungen in vertrauenswürdigem Anwendungscode.
- Wenden Sie Autorisierungsbeschränkungen auf das Retrieval an und prüfen Sie die final ausgewählten Passagen, bevor sie das Modell erreichen.
- Behandeln Sie abgerufenen Text als nicht vertrauenswürdige Daten. Eine Anweisung in einem Dokument, Geheimnisse preiszugeben oder ein Werkzeug aufzurufen, darf die Richtlinien der Anwendung nicht aushebeln.
- Beschränken Sie Werkzeuge auf notwendige Operationen; prüfen Sie Argumente, Berechtigungen und Geschäftsregeln unabhängig von der Modellausgabe.
- Verlangen Sie bei folgenreichen Aktionen einen passenden Bestätigungs- oder Prüfschritt und führen Sie einen minimalen Audit-Trail.
Kontrollieren Sie Kosten, ohne falsche Antworten zu teilen
Erfassen Sie die Kosten für Retrieval, Embeddings, Reranking und Generierung getrennt, zusammen mit der p50- und p95-Latenz. Begrenzen Sie den Kontext auf Passagen, die bei der Beantwortung helfen, deckeln Sie die Ausgabelänge und wählen Sie die Modellleistung anhand Ihres Evaluierungssets.
Beginnen Sie beim Caching mit exakten Treffern und einer klaren Invalidierungsstrategie. Grenzen Sie Schlüssel nach Mandant, Version der Zugriffsrichtlinie, Dokumentversion, Modell und Prompt-Version ab. Ähnliche Formulierungen reichen nicht aus, um festzustellen, dass zwei Nutzer Anspruch auf dieselbe Antwort haben. Ein semantischer Cache braucht zusätzliche Tests auf Fehltreffer und veraltete Antworten; er verursacht weiterhin Retrieval- oder Embedding-Arbeit.
Veröffentlichen Sie mit einem messbaren Abnahmekriterium
Legen Sie Schwellenwerte fest, die zum Risiko des Anwendungsfalls passen. Testen Sie Quellenangaben, Verweigerungen, Berechtigungsgrenzen, bösartige Dokumente, Timeouts und Werkzeugfehler. Strukturiertes JSON kann das Parsen zuverlässig machen, doch ein gültiges Schema macht weder eine Aussage wahr noch eine Aktion zulässig.
Prüfen Sie nach dem Release fehlerhafte Antworten und Retrieval-Fehlschläge. Nehmen Sie sie in ein zurückgehaltenes Regressionsset auf, statt nur auf eine Demo hin zu optimieren. Zeigen Sie dem Nutzer die stützende Quelle und machen Sie Unsicherheit sichtbar, wenn das verfügbare Material die Frage nicht klären kann.
Häufige Fragen
Verhindert RAG, dass ein KI-System Antworten erfindet?
Nein. Retrieval kann nützliche Belege liefern, doch die Passagen können unvollständig, veraltet oder irrelevant sein, und das Modell kann sie falsch deuten. Prüfen Sie, ob die endgültige Antwort durch die ausgewählten Quellen gestützt wird, und legen Sie fest, wann das System verweigern oder eskalieren soll.
Wie verhindere ich, dass ein Kunde die Dokumente eines anderen sieht?
Setzen Sie Mandanten- und Dokumentberechtigungen in vertrauenswürdigem Anwendungscode durch, bevor Belege das Modell erreichen. Prüfen Sie die ausgewählten Passagen erneut und grenzen Sie Caches nach der jeweiligen Zugriffsrichtlinie und den Inhaltsversionen ab. Ein Prompt, der das Modell bittet, Berechtigungen zu respektieren, ist keine Autorisierungsgrenze.
Sollte ich Stichwortsuche, Vektorsuche oder beides verwenden?
Testen Sie zuerst repräsentative Fragen. Exakte Kennungen und Fehlercodes brauchen oft einen Stichwortabgleich, während Embeddings bei konzeptueller Ähnlichkeit helfen können. Vergleichen Sie Retrieval-Qualität, Stützung der Antworten, Latenz und Kosten, bevor Sie hybrides Retrieval oder Reranking hinzufügen.
Wann ist das Cachen einer KI-Antwort sicher?
Nur wenn Cache-Schlüssel und Invalidierungsregeln die Berechtigungs- und Aktualitätsanforderungen der Antwort wahren. Beziehen Sie, wo relevant, Mandant, Richtlinie, Dokument, Modell und Prompt-Version ein. Ähnliche Formulierungen allein beweisen nicht, dass zwei Nutzer dieselbe Antwort erhalten dürfen.
Quellen und weiterführende Literatur
Weiterlesen
Erfahren Sie mehr über KI-Anwendungsentwicklung oder lesen Sie den Leitfaden zu Queues und Idempotenz für zuverlässige Hintergrundabläufe.
Leave a Reply